Программа развития лаборатории · Этап 1
LydStone Lab: сначала доказать — потом внедрять
Лаборатория независимого аудита и квалификации ИИ-решений
Лаборатория проверяет, какие задачи можно доверить конкретной конфигурации ИИ, где заканчивается её достаточность и каких ресурсов требует результат.
Завершён первый этап программы развития лаборатории: исследование на синтетических задачах в локальной среде.
Где может быть полезна лаборатория
№1
Согласовано вчера. Изменилось сегодня.
Инженер подтвердил решение, затем в исходном документе поменялся один параметр.
Что проверяем →№2
Самое дешёвое предложение оказалось неполным.
В одном предложении поставщика включены монтаж и проверка, в другом — только оборудование, в третьем часть комплектации заменена аналогами.
Что проверяем →Какие задачи выбраны для первого этапа — и почему
Первый этап программы охватил семь групп задач, встречающихся в работе с запросами, документами и операционными сигналами.
Выбраны задачи, в которых правдоподобный ответ может скрывать ошибку, а правильность можно проверить по заранее заданным фактам, правилам и ограничениям.
- W1
Уточнение запроса и диалог
Если не хватает важного условия, ИИ должен запросить его, а не незаметно придумать за человека.
Исследован сценарий уточнения недостающих данных.
- W3
Извлечение данных из документов
Нужно находить нужный факт и отличать отсутствие данных от повода их домыслить.
Выбранный корпус оказался слишком лёгким для различения конфигураций.
- W4
Сопоставление противоречивых источников
Два убедительных источника могут расходиться. Важно заметить конфликт и не выдавать догадку за обоснованный вывод.
Исследовано распознавание неразрешимой неоднозначности.
- W5
Вывод по цепочке правил
Несколько верных шагов не гарантируют верного итога: вывод должен следовать из заданных фактов и правил.
Исследованы цепочки вывода с нарастающей сложностью.
- W6
Диагностика причин
Правдоподобное объяснение сбоя ещё не доказывает, что причина найдена и следующий шаг обоснован.
Измерения проведены; шкала сложности не дала надёжного различения конфигураций.
- W7
Мониторинг и приоритизация сигналов
Кратковременный шум легко принять за устойчивую проблему и направить внимание не туда.
Исследовано различение сигналов при изменении временного шума.
- W9
Подготовка текста с ограничениями
Гладкий текст может пропустить обязательное условие или добавить то, что прямо запрещено.
Исследовано одновременное соблюдение обязательных и запрещённых условий.
В каждой группе проверялся один синтетический сценарий с уровнями сложности. Выводы относятся к этим сценариям и проверенным конфигурациям, а не ко всем задачам группы. W3 и W6 не используются как основание для маршрутизации.
Работа с инструментами (W2) и поиск с ответами по базе знаний (W8) выделены в отдельные направления и отложены: для них нужны собственные средства проверки и методология.
Программа развития LydStone Lab
Цель программы — сделать выбор ИИ для конкретного процесса проверяемым инженерным решением: связать требования к задаче, доказательства пригодности и необходимые ресурсы.
Первый этап заложил основу: создана измерительная система CogniScope, определены группы задач, проведены воспроизводимые эксперименты и зафиксированы границы выводов. Методология прошла независимый аудит и повторную проверку с сохранением оговорок.
Дальнейшее развитие связано с проверками на клиентских примерах, расширением сценариев и исследованием работы в разных условиях. Перенос между оборудованием, нагрузка и эксплуатационная надёжность требуют самостоятельных проверок; результаты первого этапа их не подменяют.
CogniScope — технологическое ядро программы
CogniScope — исследовательская система квалификации ИИ, на которой развивается доказательная база LydStone Lab. Она связывает сценарии, конфигурации моделей, воспроизводимые запуски, оценку ответов, ресурсные измерения и отчёты с исходными данными эксперимента.
В первом этапе программы эта система использовалась для локальных синтетических испытаний. Следующие направления развивают её возможности; их готовность должна подтверждаться отдельными результатами.
Единица проверки — сочетание «конфигурация × рабочая нагрузка × профиль выполнения». Качество рассматривается вместе с задержкой, видеопамятью и объёмом ответа.
В проверенных сценариях граница достаточности одной конфигурации меняется от задачи к задаче. Например, 27B Q4 без рассуждения достигает L0 в задаче неразрешимой неоднозначности, L1 в выводе по цепочке правил и L2 в тексте с ограничениями.
Уровни L0–L3 относятся к сложности внутри каждого сценария. L3+ означает, что весь проверенный диапазон пройден и граница в нём не обнаружена. Результатов за пределами этого диапазона оно не обещает.
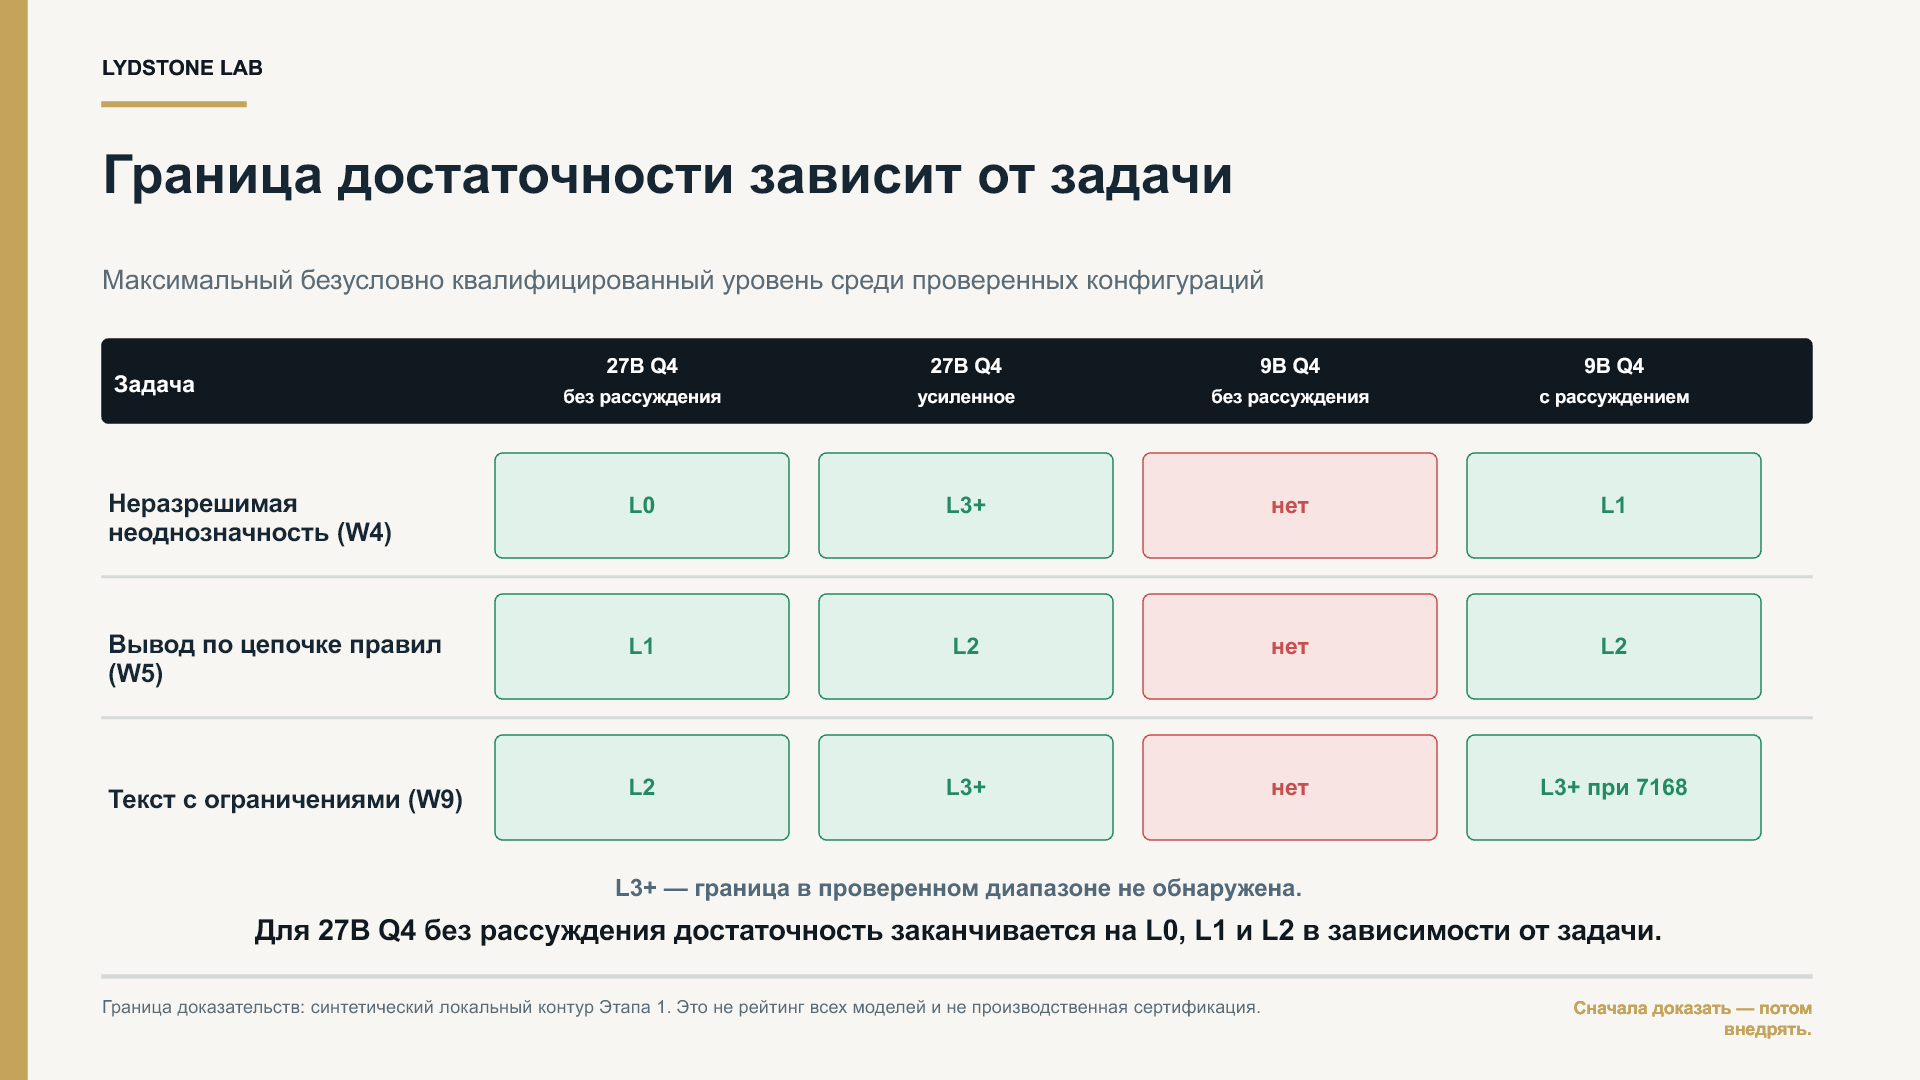
Граница достаточности зависит от задачи. L3+ означает отсутствие обнаруженной границы в проверенном диапазоне.
Результаты Этапа 1 на синтетическом локальном контуре.
Открыть в полном размереТри результата первого этапа программы
W4
97,4 % случаев прошли. Почему вердикт — «не прошёл»
В задаче распознавания неразрешимой неоднозначности, W4, конфигурация 27B Q4 без рассуждения прошла L0: 30 из 30 случаев, без критических ошибок. Медианная задержка — 884 мс, объём ответа — 51 выходной токен.
На L1 прошли 38 из 39 случаев. Однако одна ошибка нарушила заранее установленное правило нулевого допуска к критическим ошибкам. Вердикт — НЕ ПРОШЁЛ (RED).
Доля прошедших случаев не заменяет условия приёмки. Недопустимую для процесса ошибку нельзя компенсировать хорошим средним результатом.
С усиленным рассуждением та же 27B Q4 прошла проверенный диапазон до L3: на L3 — 15 из 15 случаев, медианная задержка 12 719 мс и 732 выходных токена.
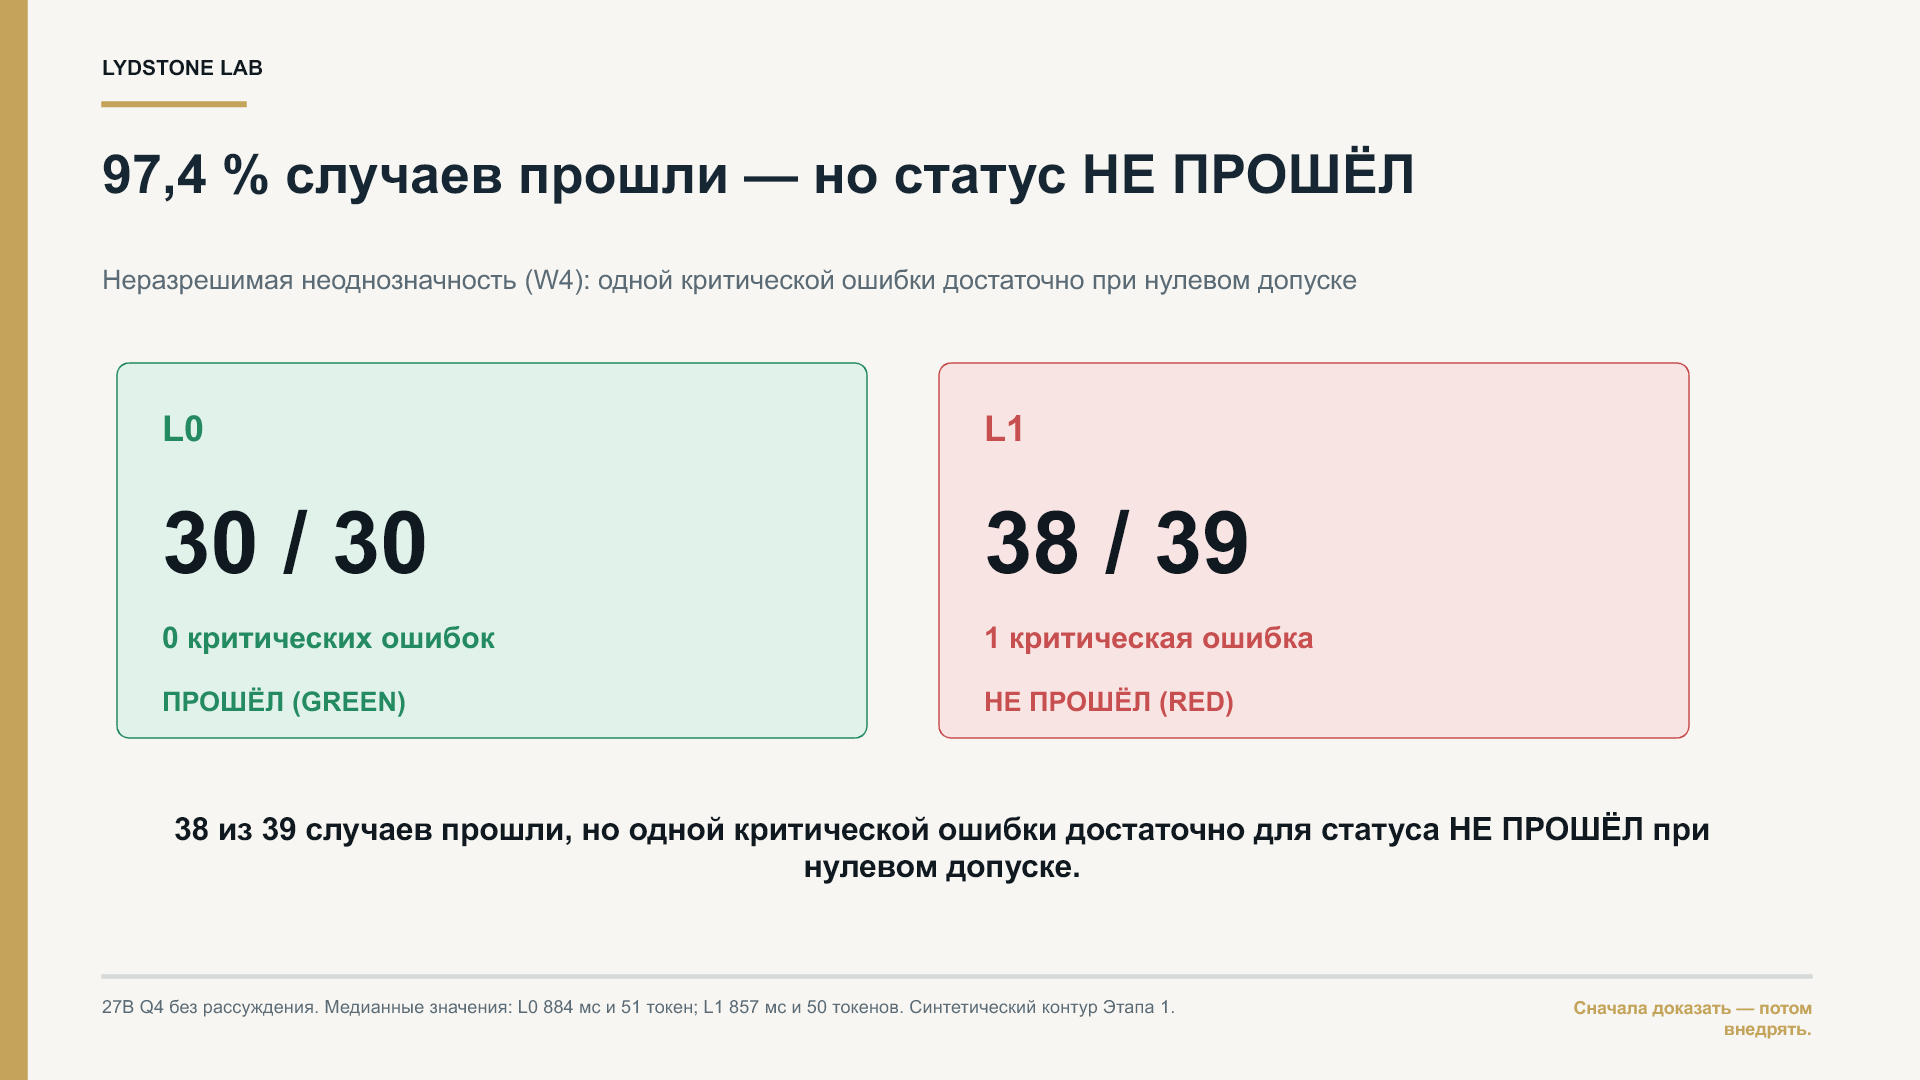
27B Q4 без рассуждения: одна критическая ошибка на L1 приводит к отрицательному вердикту при нулевом допуске.
Результаты Этапа 1 на синтетическом локальном контуре.
Открыть в полном размереW9
Следующий уровень способности имеет ресурсную цену
В задаче работы с обязательными и запрещёнными условиями, W9, конфигурация 27B Q4 без рассуждения прошла L2: 14/14 случаев, 1 482 мс, 58 выходных токенов, 20 809 МБ видеопамяти.
27B Q4 с усиленным рассуждением прошла L3: 16/16 случаев, 15 540 мс, 839 выходных токенов, 20 807 МБ видеопамяти.
Переход между этими подтверждёнными уровнями связан примерно с 10,5-кратным ростом задержки и 14,5-кратным ростом числа выходных токенов. Видеопамять осталась около 20,8 ГБ.
Одновременно меняются сложность и режим рассуждения. Это цена перехода между подтверждёнными уровнями, не чистый эффект рассуждения.
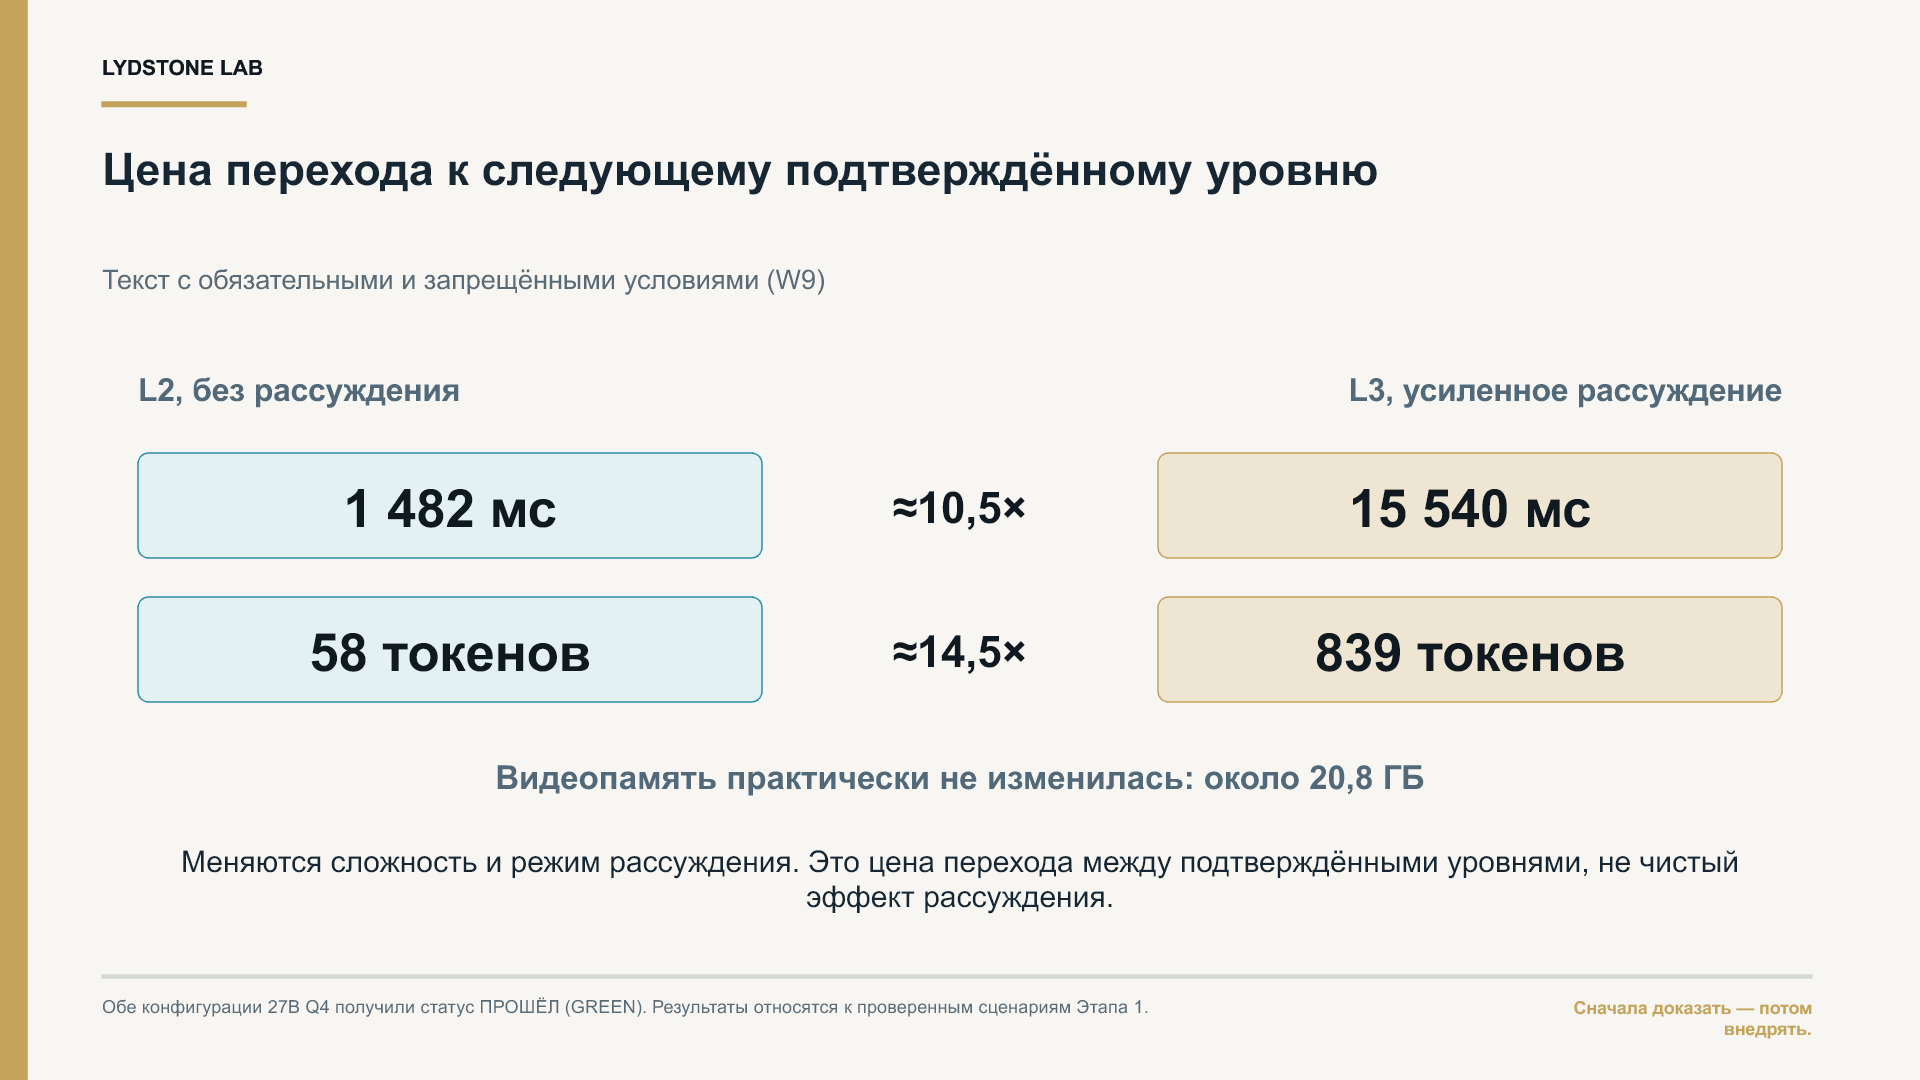
Сравнение подтверждённых L2 и L3. Меняются сложность и режим рассуждения; чистый эффект рассуждения не выделен.
Результаты Этапа 1 на синтетическом локальном контуре.
Открыть в полном размереW5
Обоснованный отказ от рекомендации — тоже результат
В задаче вывода по цепочке правил, W5, ни одна проверенная конфигурация не получила на L3 безусловного статуса ПРОШЁЛ (GREEN).
Две конфигурации 27B с усиленным рассуждением получили статус УСЛОВНО (AMBER): Q4 — 21/22, Q6 — 21/23. НЕ ПРОШЛИ (RED): 9B Q4 с рассуждением — 3/4; 27B Q4 без рассуждения — 3/6; 9B Q4 без рассуждения — 2/6.
Такой результат сохраняется в заключении. Следующим шагом может стать изменение декомпозиции, уточнение критериев или новая проверка. Назначать победителя при недостаточных доказательствах оснований нет.
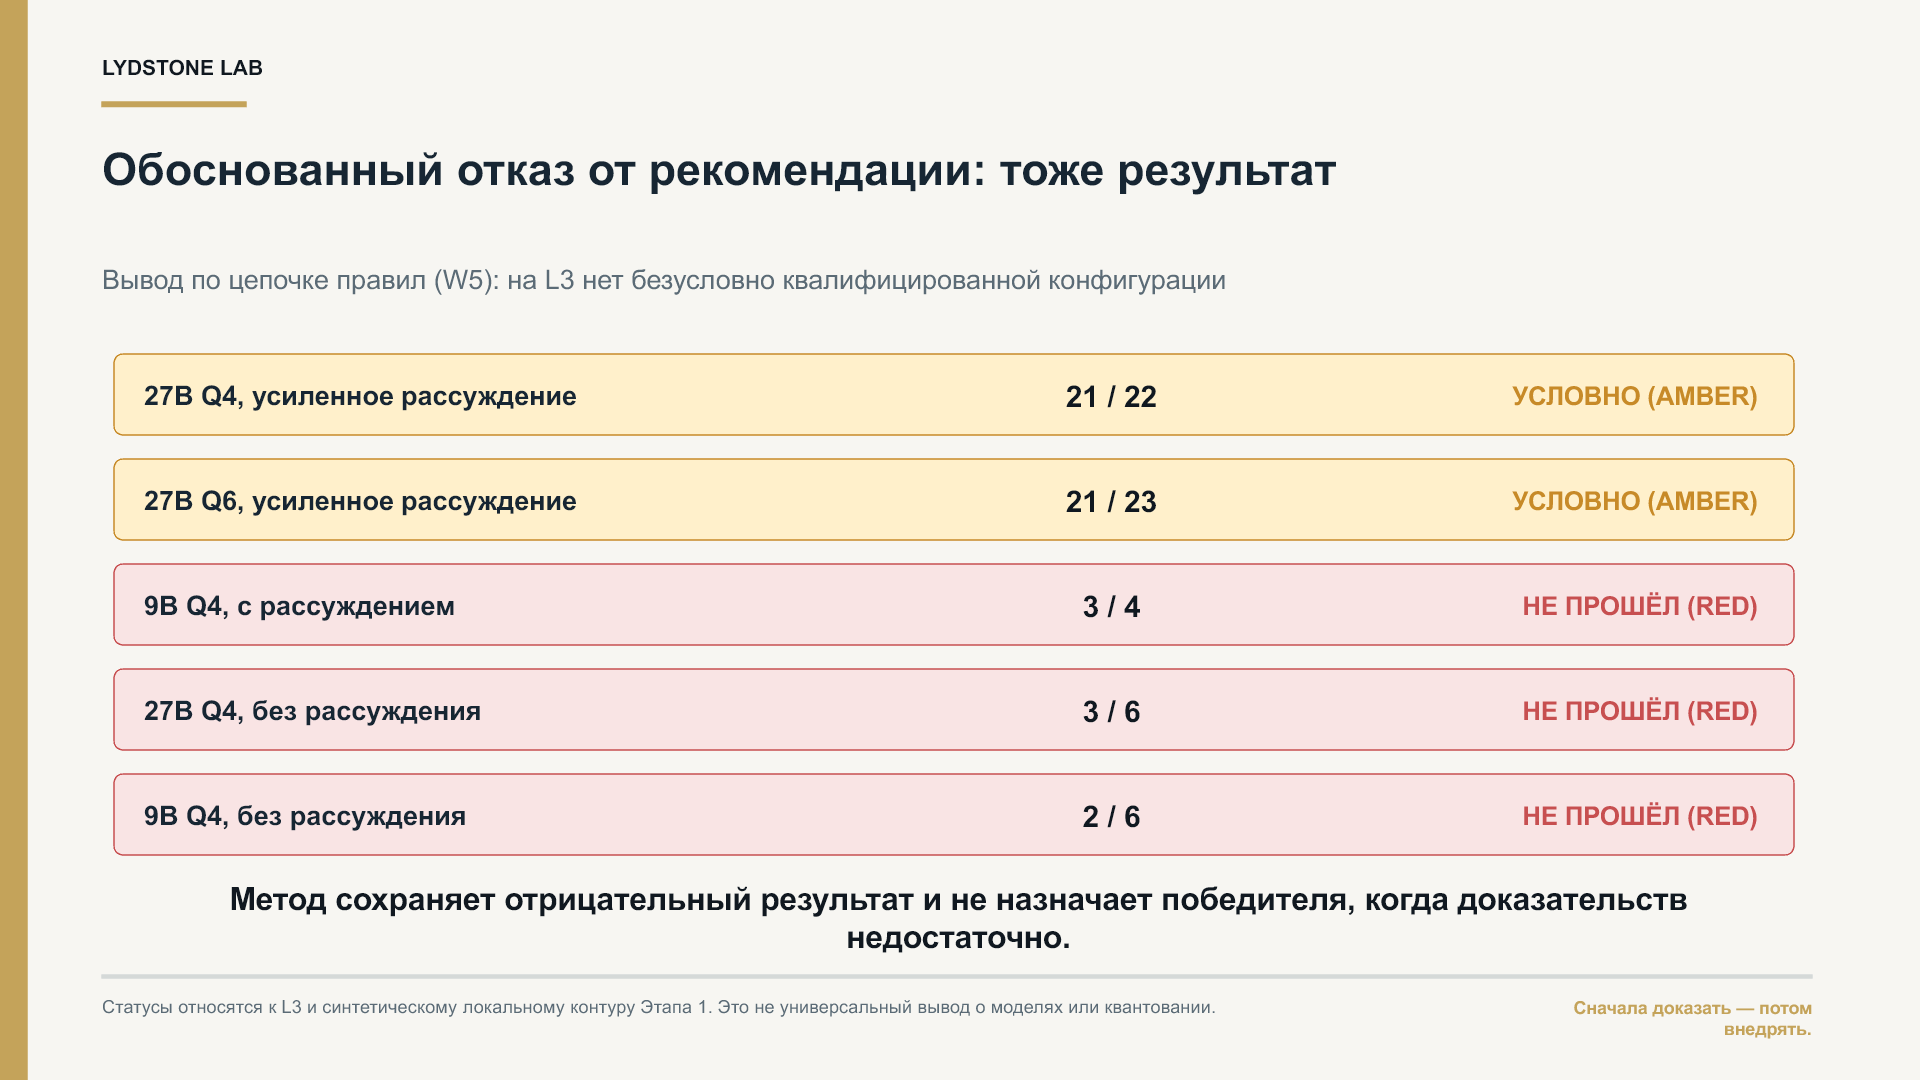
Среди проверенных конфигураций на L3 нет безусловно квалифицированной. Условные и отрицательные результаты сохранены.
Результаты Этапа 1 на синтетическом локальном контуре.
Открыть в полном размереЧто подтверждено и где заканчиваются выводы
Первый этап программы развития лаборатории подтвердил базовую способность метода измерять достаточность конфигурации для конкретной ИИ-задачи на синтетическом локальном контуре.
Методология прошла независимый аудит, доработку по замечаниям и повторную независимую проверку. Аудиторские заключения содержат оговорки; завершение этапа их не отменяет.
Исследование ограничено одним хостом, сценариями Этапа 1 и пилотной статистикой. Процедура поиска границы требует дальнейшей валидации. Сравнение конфигураций разных поколений и режимов не доказывает чистое влияние размера модели.
Этап 1 не подтверждает промышленную безопасность, работу под нагрузкой и параллельными запросами, экономику облачного и локального выполнения, гибридную маршрутизацию или полную ревизию клиентской архитектуры.
Недостаточно различающие результаты W3 и W6 сохранены и не используются как основание для маршрутизации. W2 и W8 отложены.
Зафиксированная доказательная база первого этапа программы: cogniscope-stage1b-final0dac1339fbaa2cb51741c102bdfa0ac148936d9a
Предлагаемая услуга
Квалификационный спринт (Decision Sprint)
Лаборатория предлагает проверить 1–2 критические ИИ-задачи или узла до крупного пилота, закупки или фиксации архитектуры.
Сначала обсуждаем решение, которое зависит от результата проверки. Затем фиксируем гипотезу, ревизуем разделение работы между ИИ, обычным кодом и человеком, согласуем конфигурации, примеры и критерии приёмки.
Что потребуется
- Архитектурная гипотеза или граф работ
- Обезличенные либо синтетические примеры
- Ограничения по данным и среде выполнения
Что вы получите
- Заключение, карта критических узлов и критериев
- Матрица проверенных конфигураций и подтверждённые или отклонённые предположения
- Ресурсный профиль, границы применимости и следующий шаг проверки
Обычно спринт занимает 1–2 недели после готовности входных данных. Точный состав, срок и цена фиксируются после установочной встречи на 30–45 минут.
Архитектура и итоговое решение остаются у клиента. Спринт не является сертификацией безопасности и не заменяет нагрузочную проверку. Экономика облачного и локального выполнения и гибридная маршрутизация требуют отдельной проверки. Проверка на реальных данных внутри клиентского контура и последующие эксплуатационные этапы согласуются отдельно.
Опишите задачу, решение, которое предстоит принять, и ошибку, которую нельзя допустить. Этого достаточно для первого сообщения.
Обсудить квалификационный спринтДмитрий Ванеев · LydStone Lab